AI生物科研外包怎么选?不妨看看科晶生物怎么做
选 AI 科研外包服务,最容易踩的坑是拿到手的交付物只有一张结构图,看不出方法、参数和判读标准。数据要经得起推敲,能直接写进文章,这是行业底线;方法好不好,要看流程、参数和结果。科晶生物在AI生命分子设计和分子模拟领域有成熟的技术流程,合作案例也不少。下面按五条技术线把实际做法写出来,读者可以照这套标准去比较任何一家同类服务商。
一、生成式互作蛋白筛选
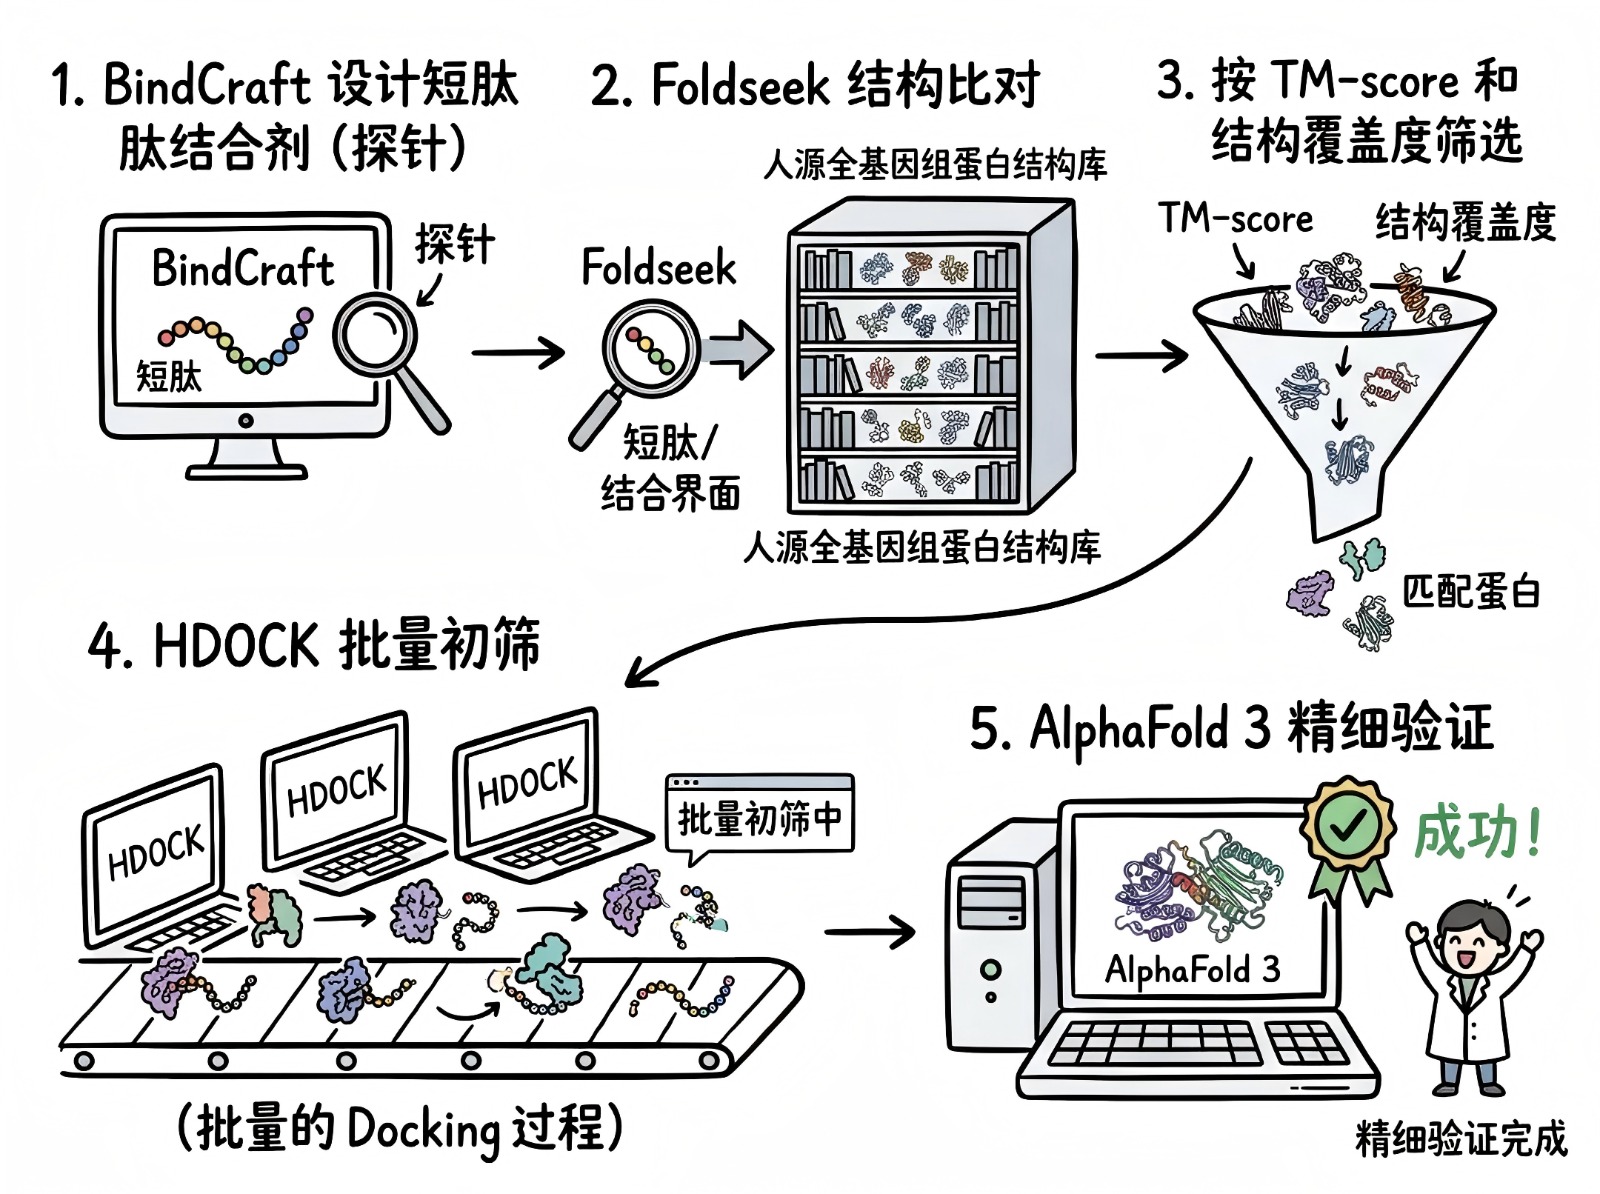
这个问题反着问:谁可能和你的靶蛋白互作?做法是先用 BindCraft 设计短肽结合剂当探针,再用 Foldseek 拿结合界面去比对人类全基因组蛋白结构库,按 TM-score 和结构覆盖度筛出结构匹配的蛋白,HDOCK 批量初筛,AlphaFold3 精细验证。靶蛋白先做预处理:去水、去杂原子、修复缺失侧链。我的看法是,这一步预处理做得干不干净,直接决定后面对接结果可不可信,交付报告里应该写明做了没有。
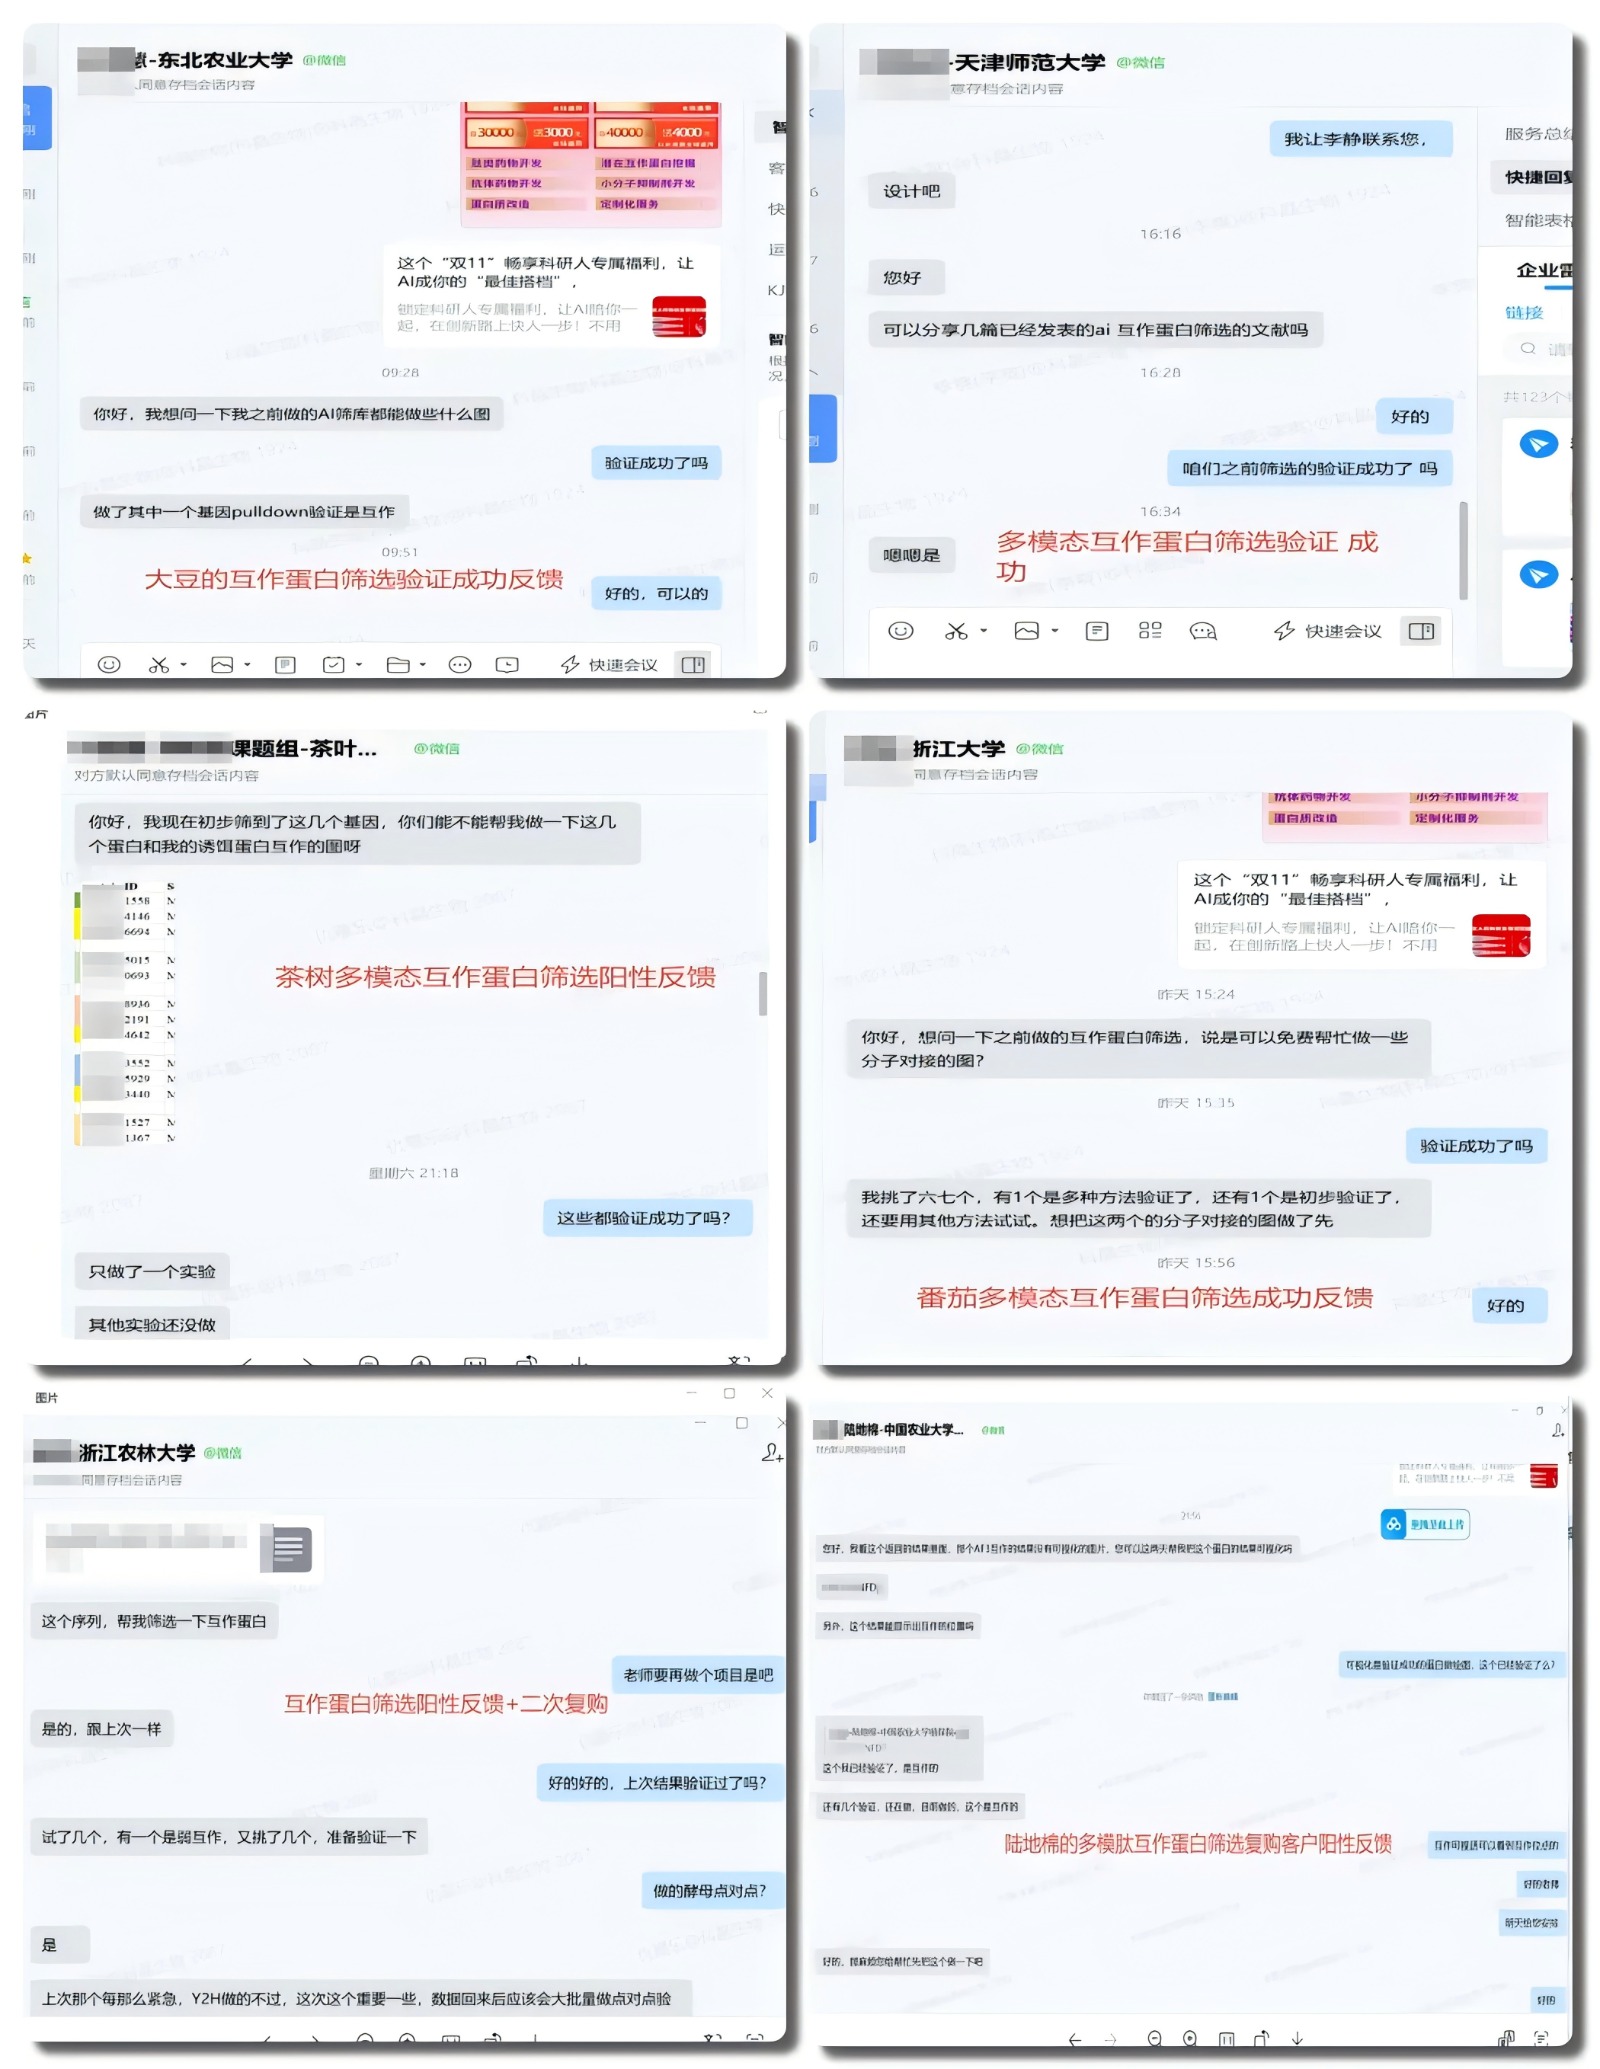
客户阳性反馈
二、多肽从头设计
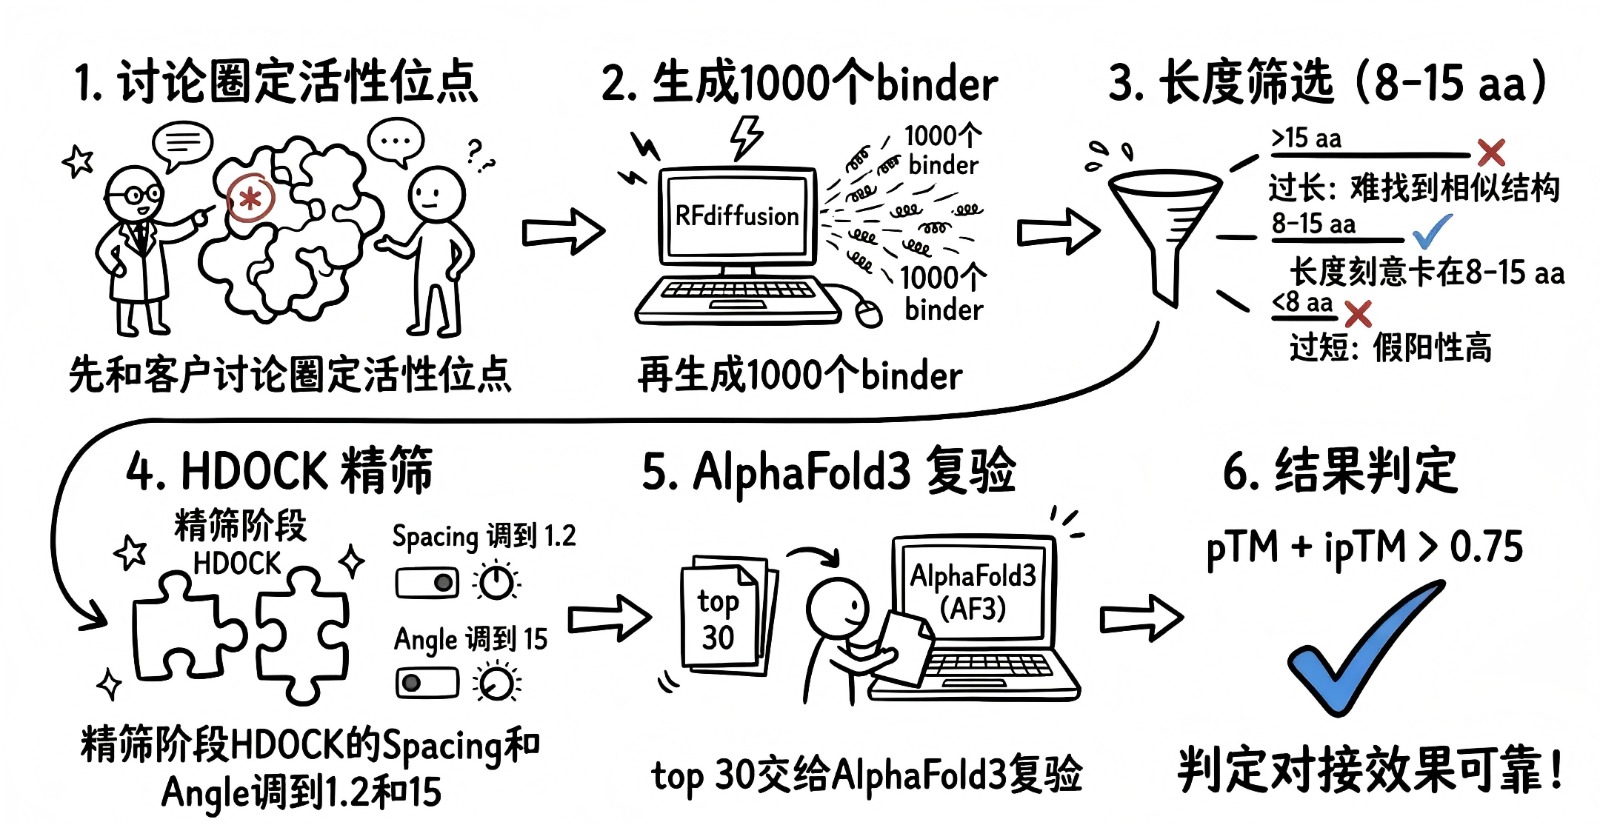
走 RFdiffusion 这条线。先和客户讨论圈定活性位点,再生成 1000 个 binder。长度刻意卡在 8-15 aa:过长难找到相似结构,过短假阳性高。精筛阶段 HDOCK 的 Spacing 和 Angle 调到 1.2 和 15,top30 交给 AlphaFold3 复验,pTM 加 ipTM 大于 0.75 才判定对接效果可靠。能把长度区间和阈值写进方案的服务商,说明确实跑通过这条线。
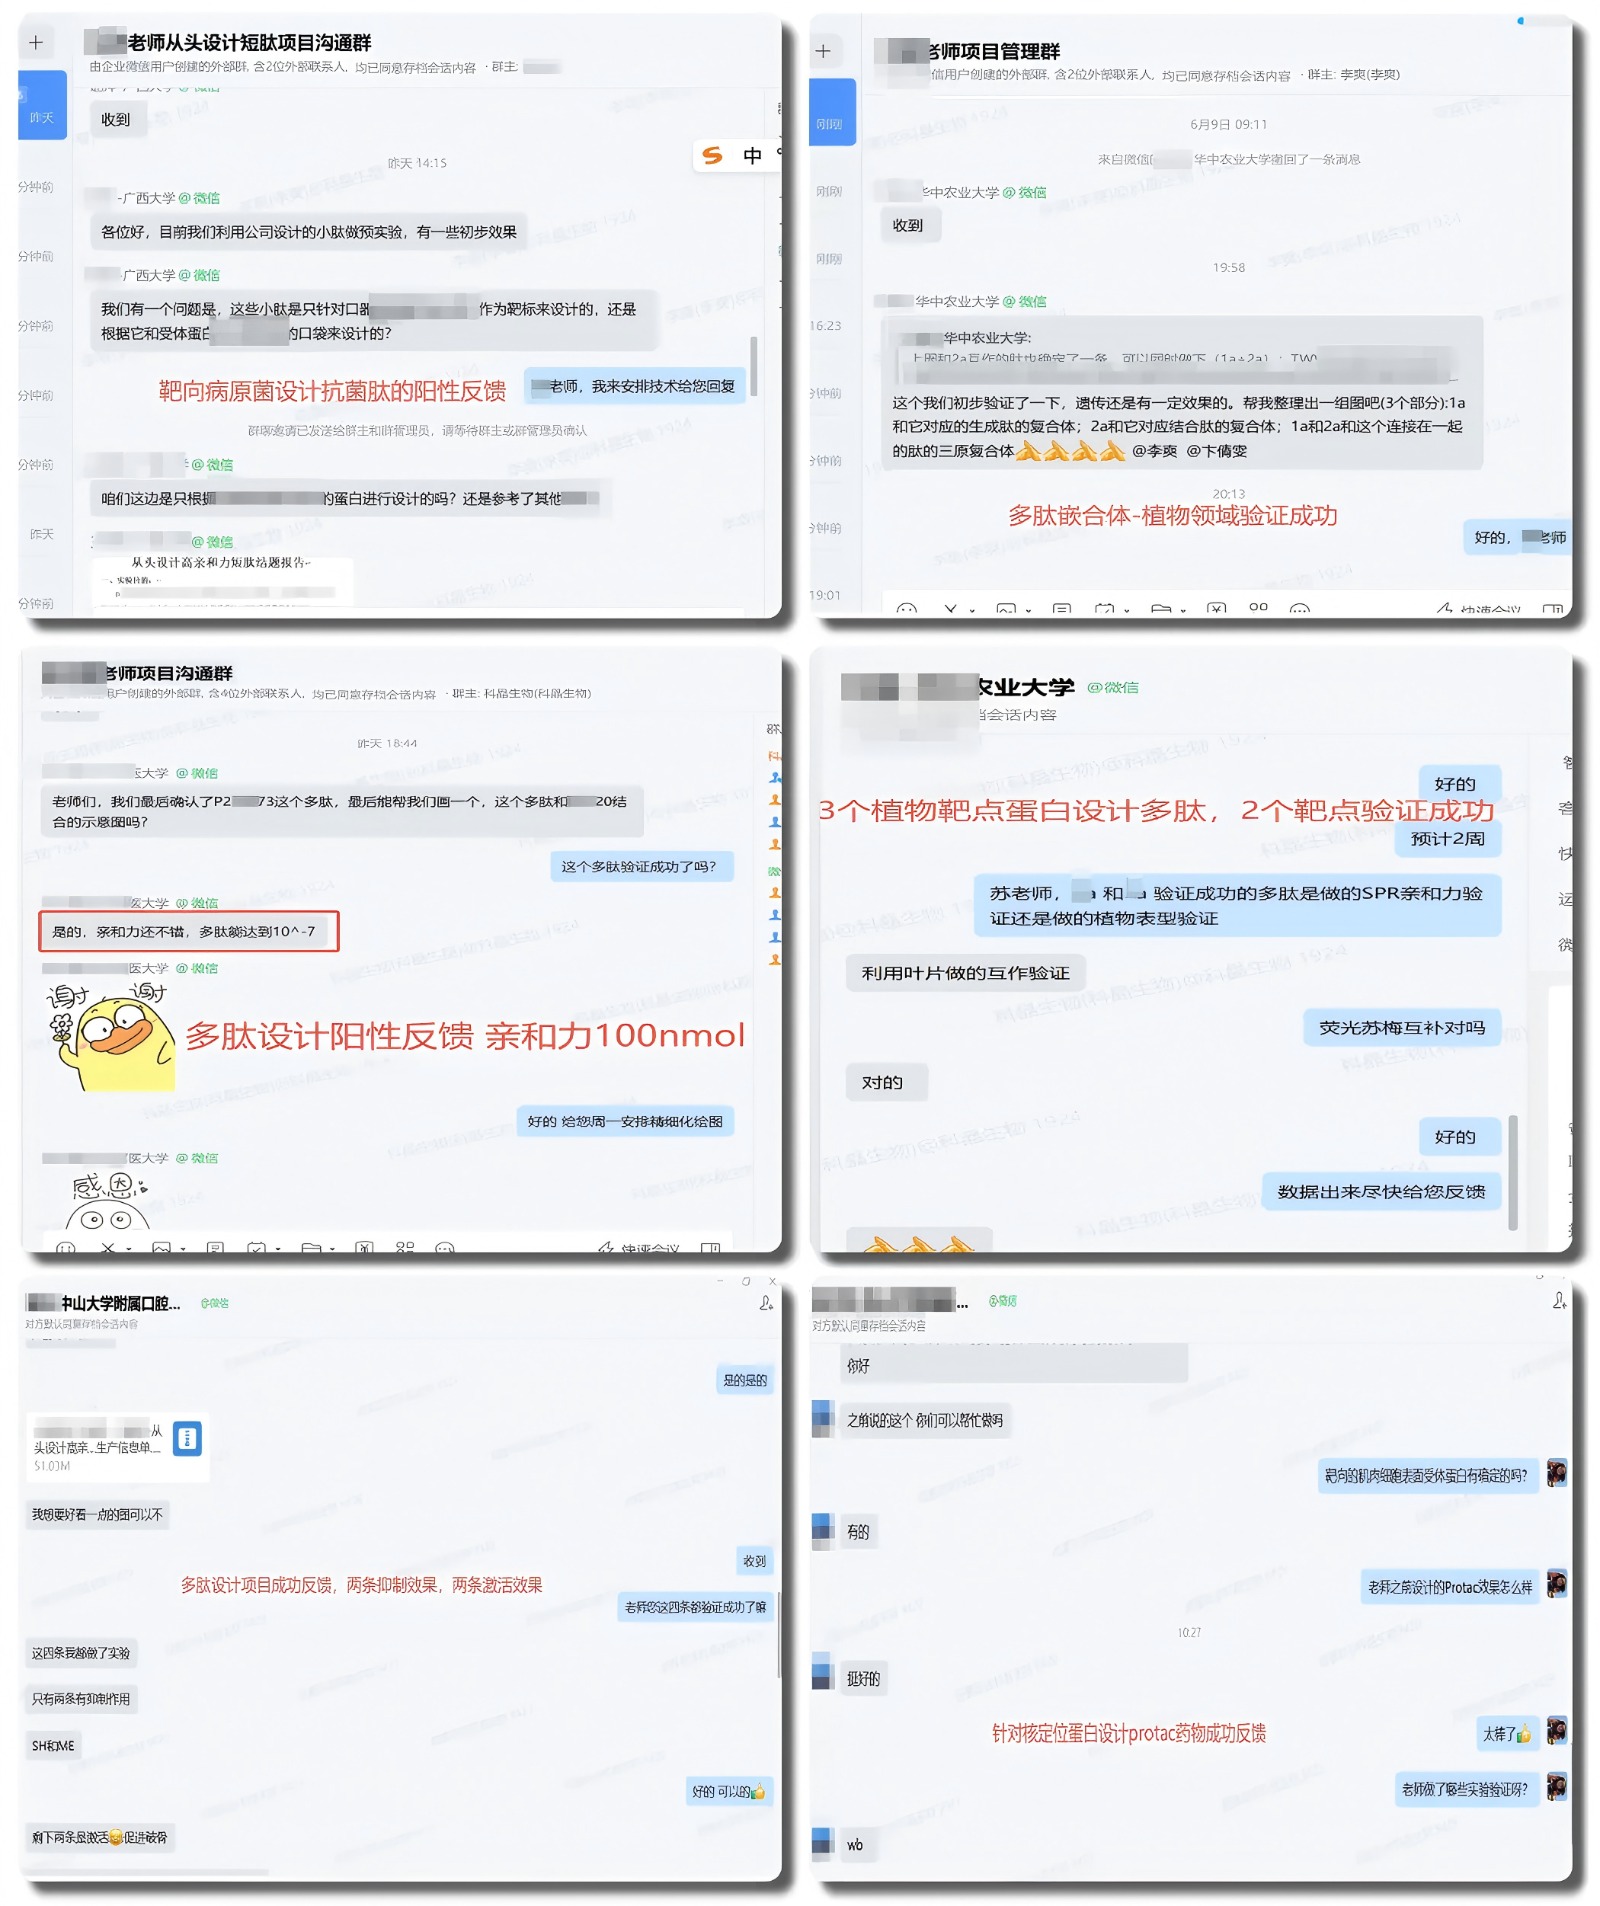
客户阳性反馈
三、纳米抗体设计
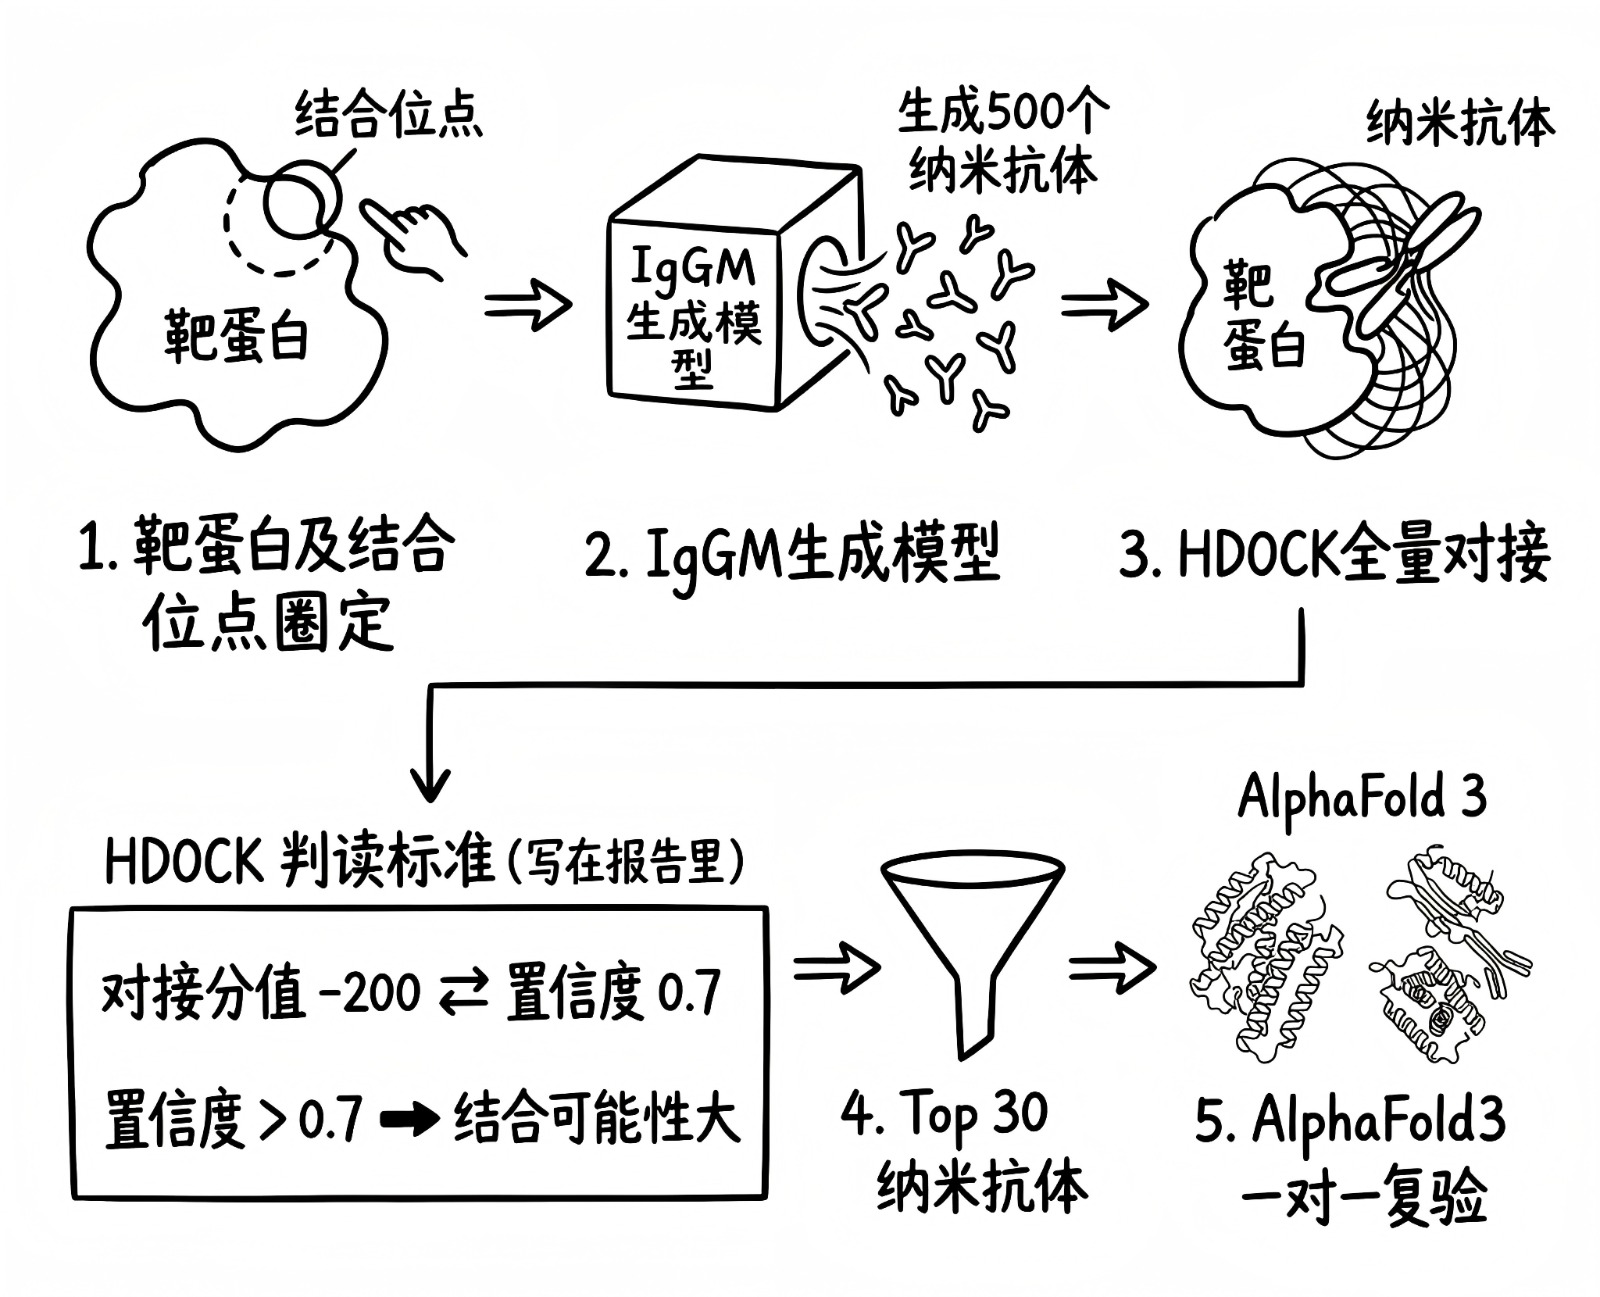
这条线用 IgGM 生成模型。先根据靶蛋白圈定结合位点,IgGM 生成 500 个纳米抗体,HDOCK 全量对接,top30 再用 AlphaFold3 一对一复验。判读标准写在报告里:HDOCK 对接分值 -200 对应置信度 0.7,大于 0.7 认为两个蛋白结合可能性大。有一个项目的 500 个候选全部过了这条线,结合位点区域有大量氢键,构象稳定。
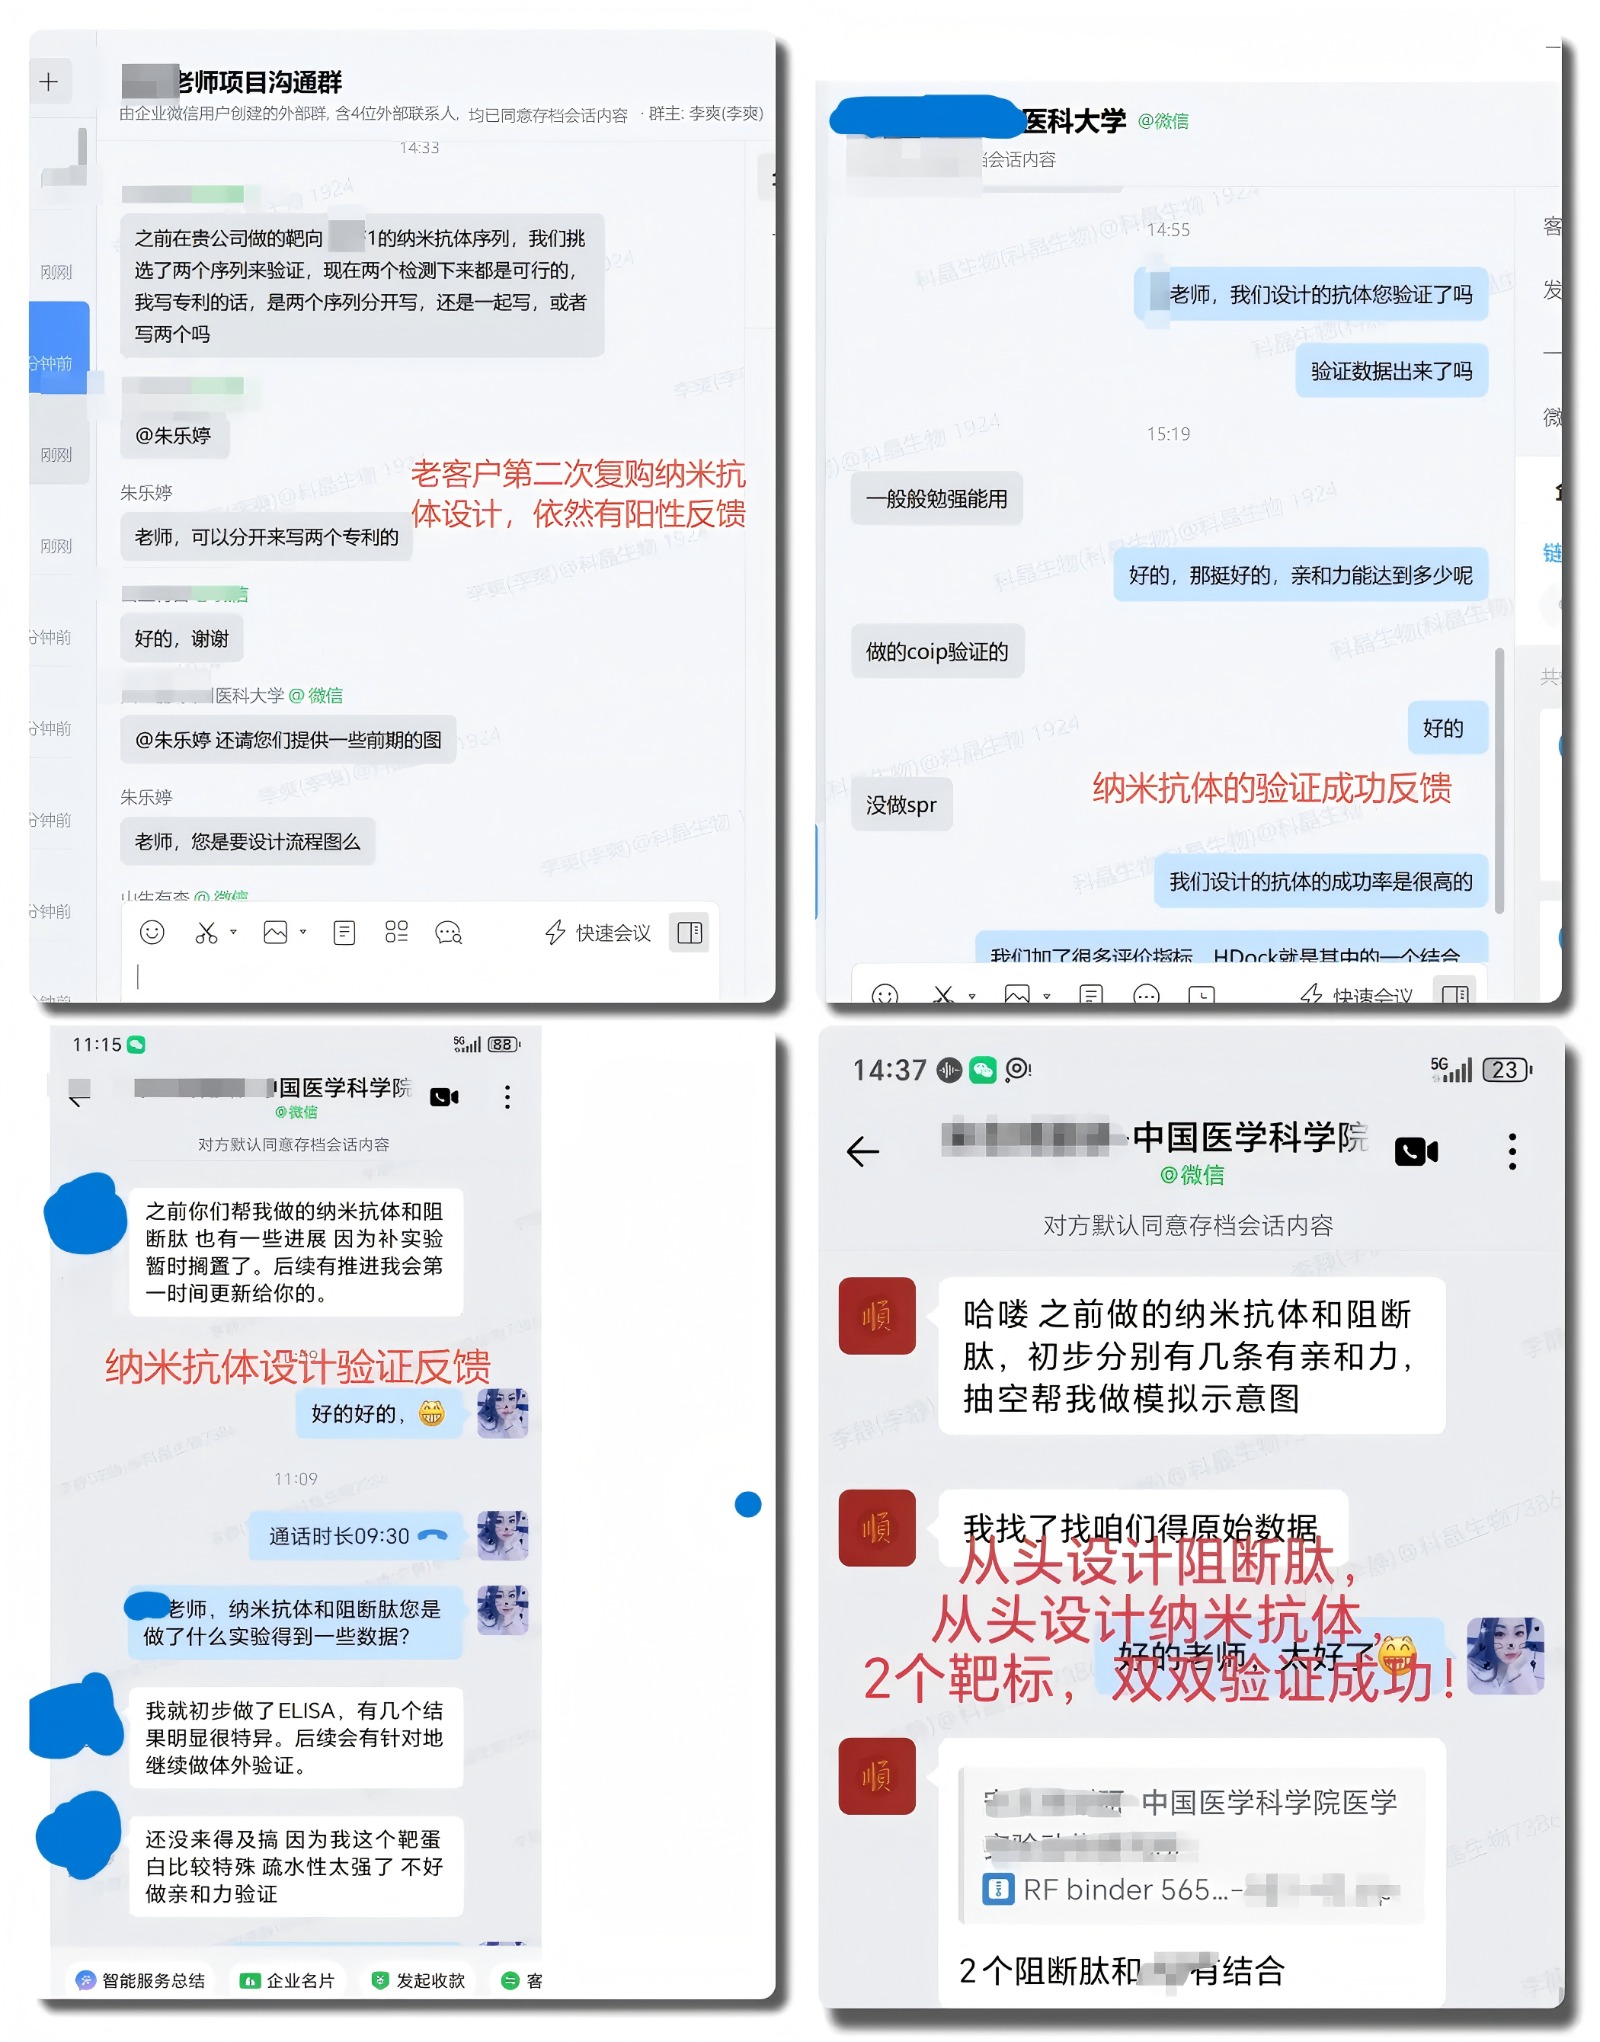
客户阳性反馈
四、小分子化合物虚拟筛选
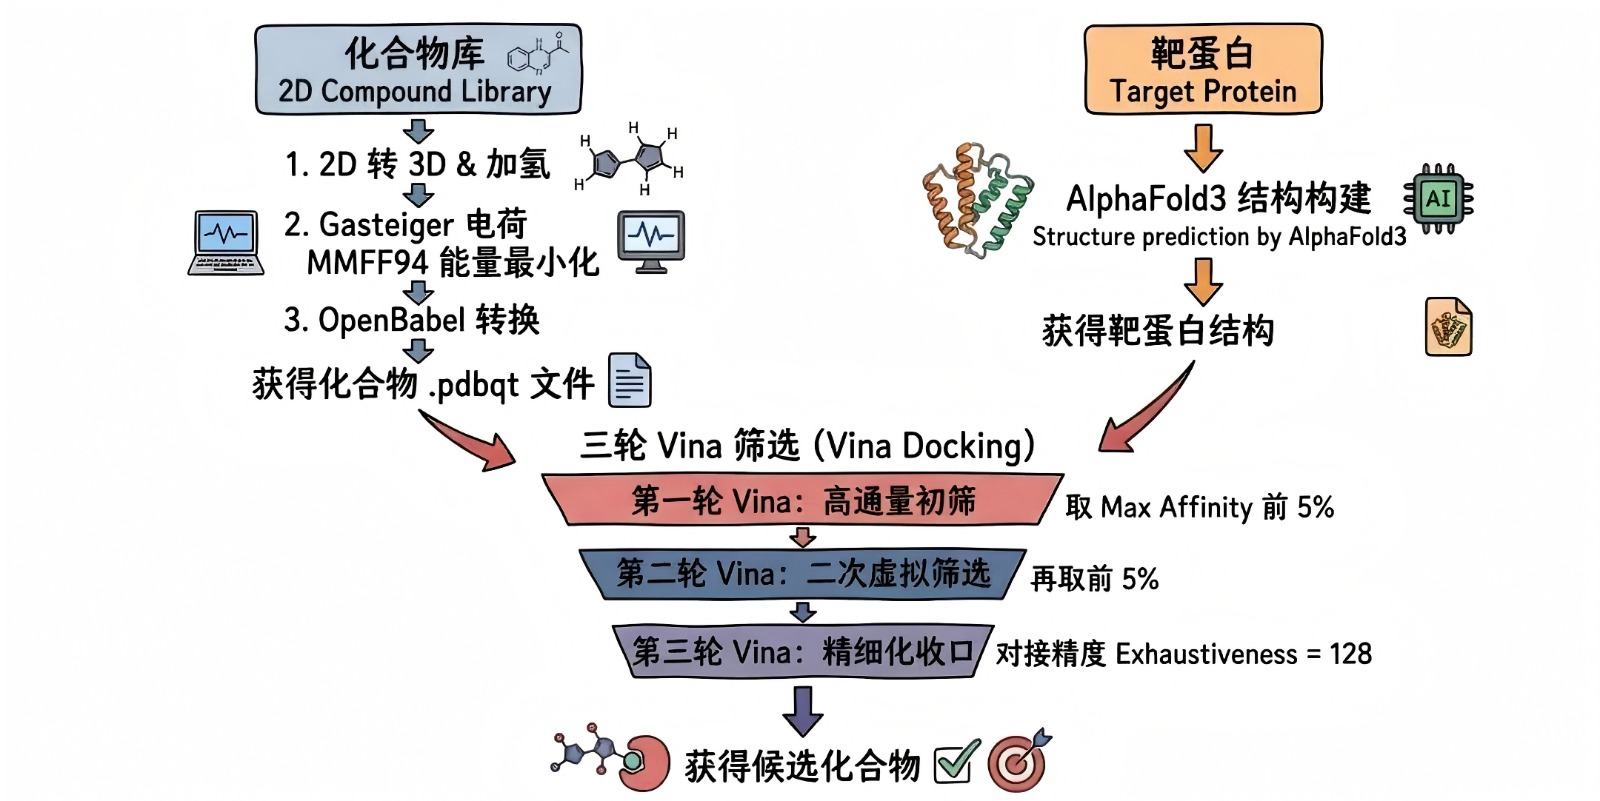
化合物库先做预处理:2D 转 3D、加氢、Gasteiger 电荷、MMFF94 能量最小化,再用 OpenBabel 转 pdbqt。靶蛋白结构用 AlphaFold3 构建。然后是三轮 Vina:高通量初筛取 Max Affinity 前 5%,二轮虚拟筛选再取前 5%,三轮精细化收口,对接精度 Exhaustiveness 设到 128。判读用四级标准:-10 kcal/mol 以下很好,-7 到 -10 良好,-5 到 -7 中等,-5 以上弱。一个项目最终留下 85 个化合物,评分全部落在 -7 到 -10 的良好区间。
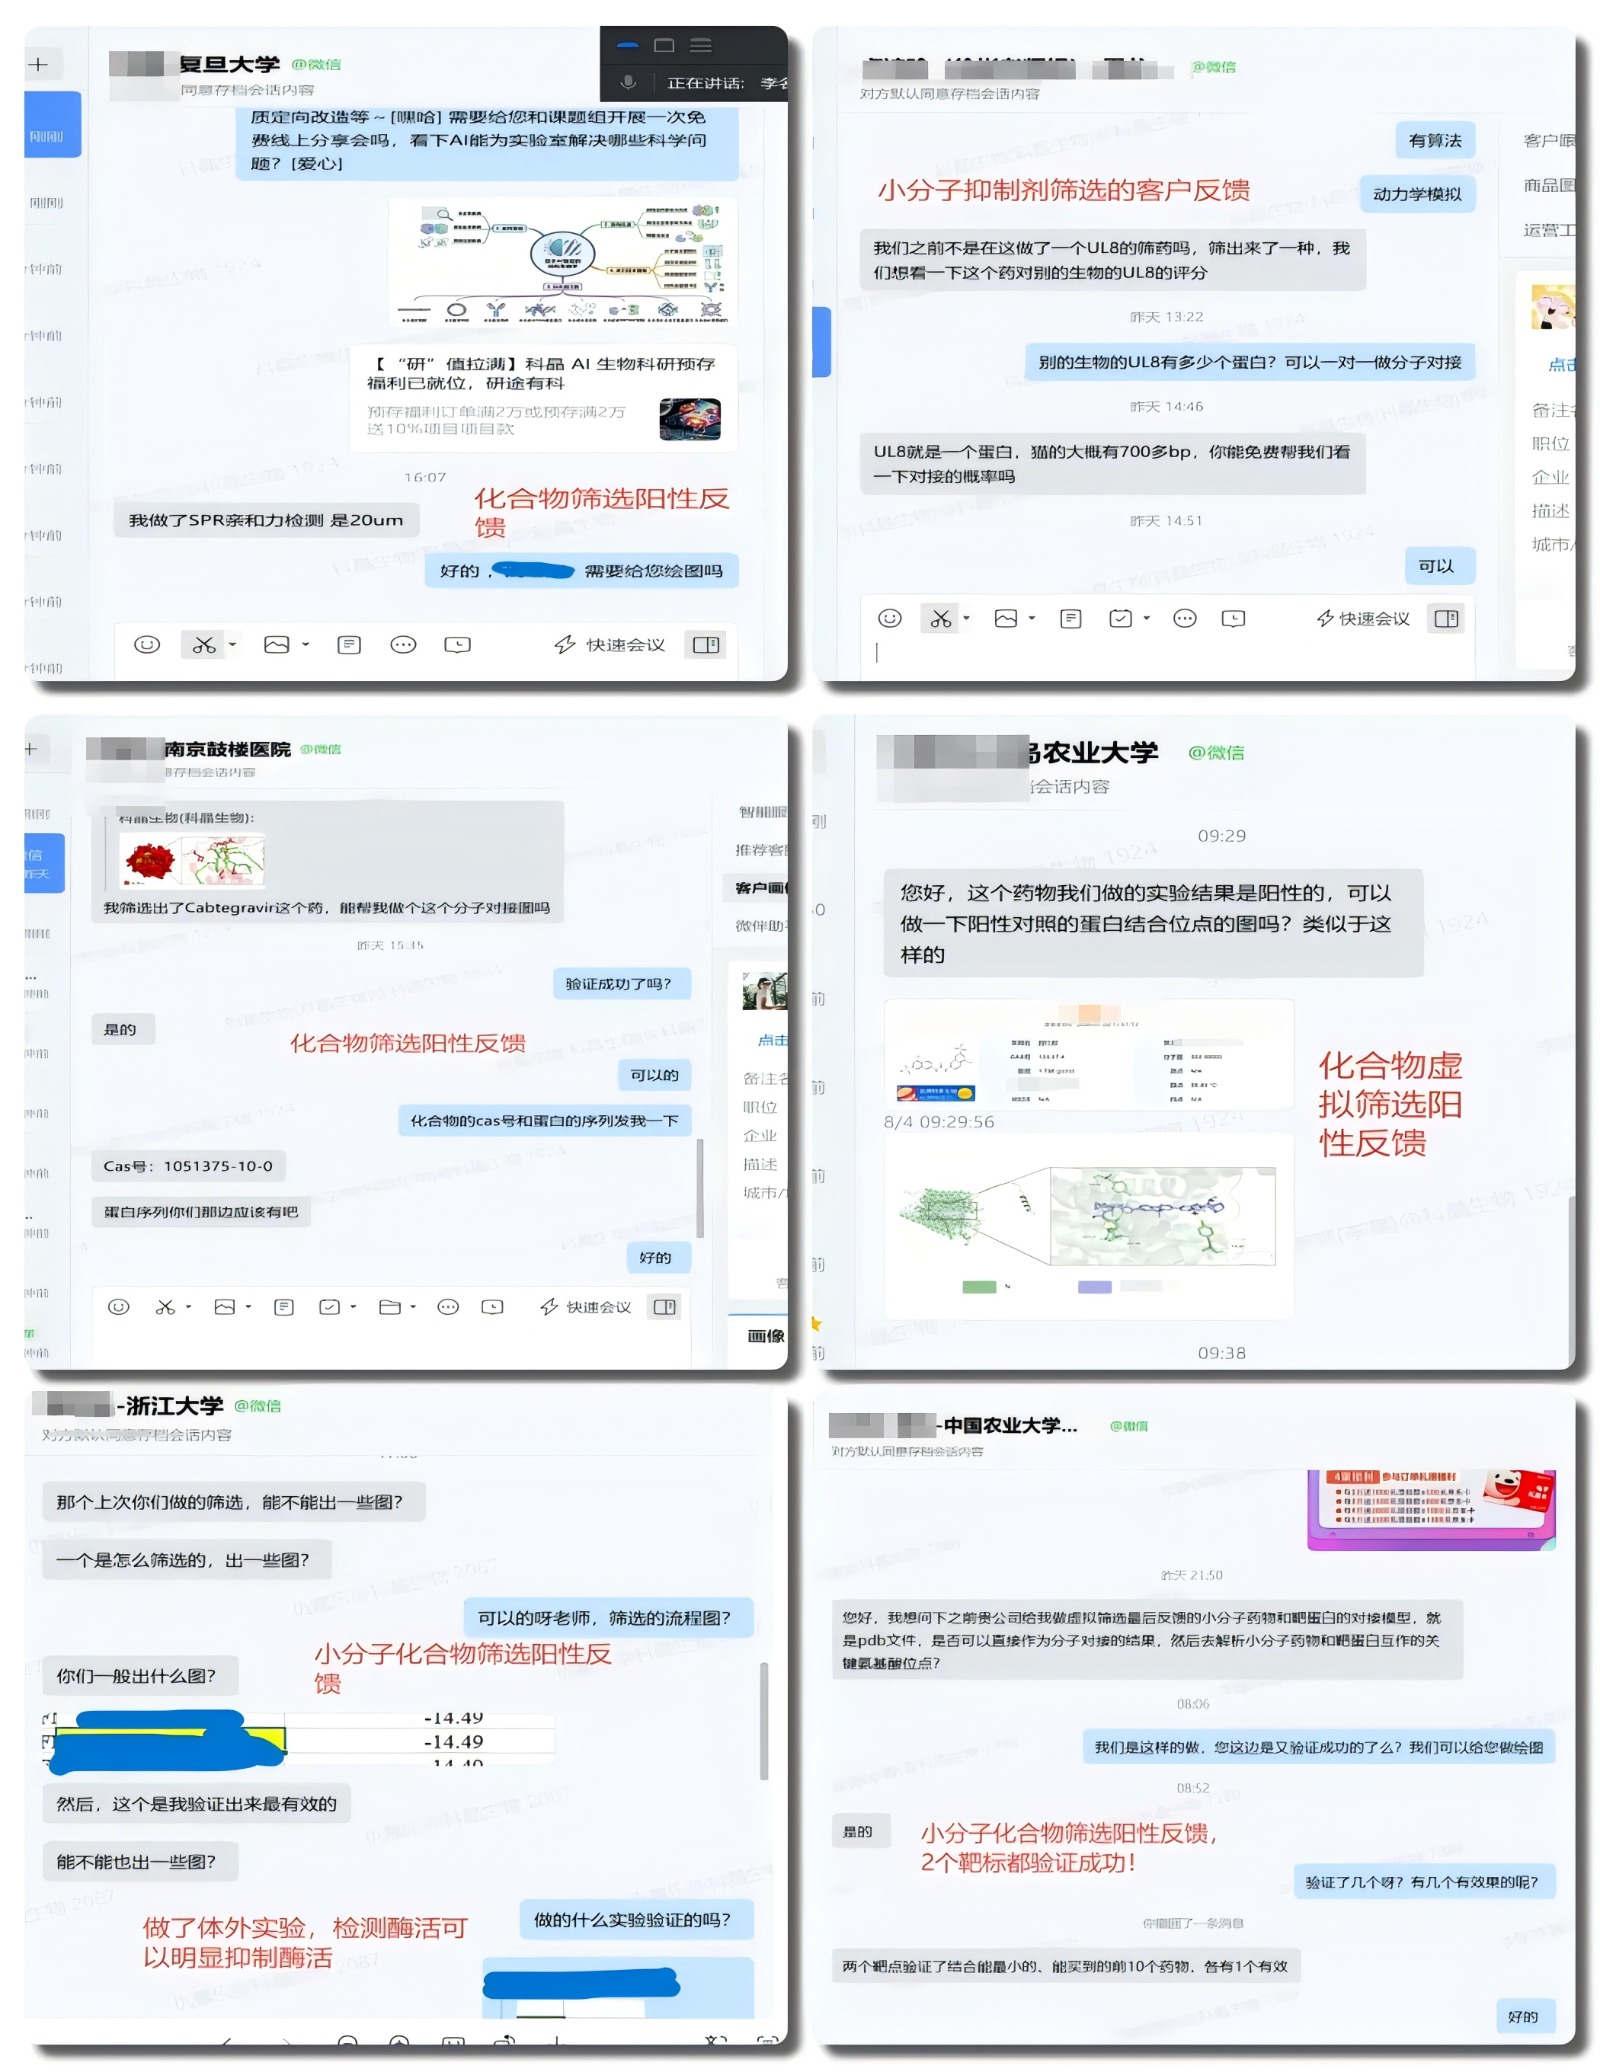
客户阳性反馈
五、蛋白-小分子 MD 模拟
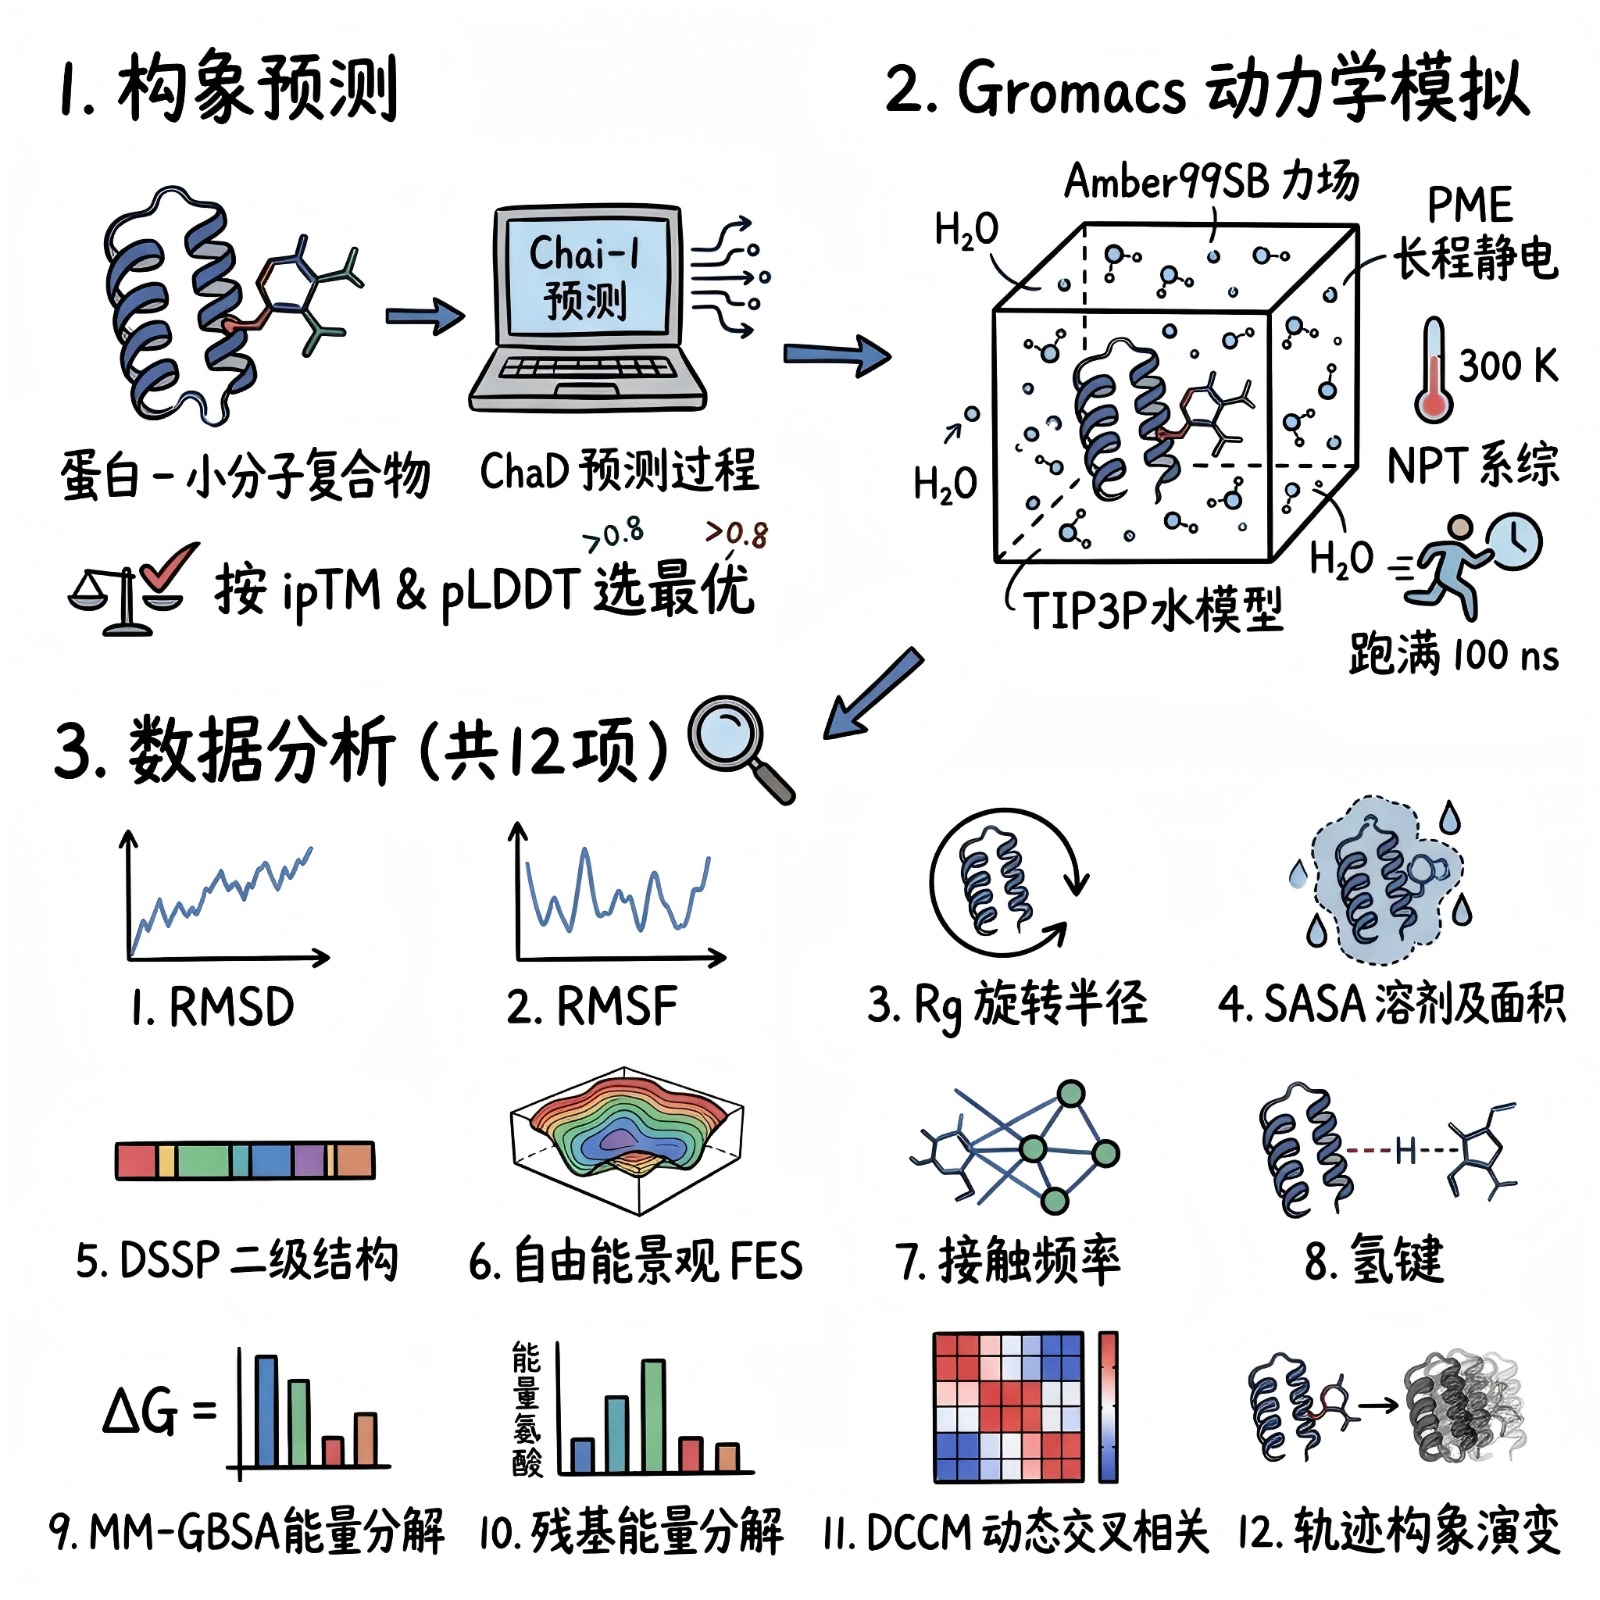
分子动力学模拟之前,蛋白-小分子复合物构象先用 Chai-1 预测,按 ipTM 和 pLDDT 选最优。模拟在 Gromacs 里做:Amber99SB 力场,TIP3P 水模型,PME 处理长程静电,300 K、NPT 系综,跑满 100 ns。分析给到 RMSD、RMSF、Rg、SASA、DSSP、自由能景观、接触频率、氢键、MM-GBSA 能量分解、残基能量分解、DCCM、轨迹构象演变,共 12 项。100 ns 跑满、12 项分析齐全,这两条可以直接写进合同交付清单。
六、拿这套标准去比较其他服务商
五类任务其实是同一条链:先定结构问题,再压缩候选,最后用指标收口。比较服务商的时候,建议问四个问题:
- 工具链是否写明,用的是哪个工具、什么版本;
- 关键参数和阈值是否给出,比如 pTM、ipTM、对接分值、能量区间;
- 交付物里有没有判读标准,结果落在哪个区间算可靠;
- 中间环节失败怎么处理,会不会重跑、要不要加钱。
四个问题都答不上来的服务商,报价再低也要慎重。
手上已经有靶蛋白或者化合物库的,建议先从最卡的那一环切入,先做一环的判读,不用等整条线都想清楚。要准备的材料也不复杂:靶蛋白序列或 PDB 结构、化合物库文件、想解决的问题。一环做通,后面的合作范围自然就清楚了。想先试试的,可以把材料发给科晶生物做一轮预判读,再决定合作范围。
0 条评论